GA4のアクセス解析と施策判定を自動化しようとスタートしたものの、実際に動かしてみると予想外の壁に次々とぶつかって、3回も設計を根本からやり直すことになったんだよね。
今回は、小規模サイト特有の統計の限界や、人間が無意識にやってしまう後出しカンニングの失敗など、泥臭い試行錯誤とそこからの学びを包み隠さず共有するよ!
個人で運営しているWebサイトを、少しでも成果が出るように改善したい。 ただ、副業や個人開発で充てられる時間は週に数時間しかありません。
この限られたリソースの中で一番困るのが、加えた改修によって本当に数字が動いたのか判断できないことでした。 そこで客観的に検証できる自動化パイプラインの構築に乗り出したのですが、最初から綺麗に組めたわけではありませんでした。
この記事は、自動化パイプラインを構築する過程で直面した統計の壁・人間の自分への甘さ・3度の設計破綻を振り返る【試行錯誤・落とし穴編】です。
現在実際に自走している完成版アーキテクチャの全容や具体的なコード構成については、以下の【実践・システム設計編】をご覧ください。
この記事では、どのような思想で始め、なぜうまくいかなかったのか、3度の作り直しを通して得られた教訓を振り返ります。
1. 差分の差分法と統計の壁
改修前後の数値を単純に比べるだけでは、ほぼ確実に誤判定を招きます。季節の変わり目や検索流入の増減など、改修とは無関係な外部要因で数字がいくらでも動いてしまうためです。
そこで最初に導入したのが、因果推論で使われる差分の差分法(Difference-in-Differences: DiD)でした。 改修したページだけでなく、改修していない別のページ(対照群)も同時に観測しておくアプローチです。
効果量 R = (改修した対象群の変化率) / (改修していない対照群の変化率)
改修していない対照群にも、サイト全体のアクセス増減は等しく影響します。両者の比を取ることで共通の外部要因を相殺し、改修による純粋な効果を比率(CV率やエンゲージメント率)で検出しようという目論見でした。
対象群と対照群のパス衝突
実装初期、ページパスの判定を前方一致で組んでいたため、対照群に誤って / を指定したところ、全ページにマッチして対象群を丸ごと飲み込んでしまう事故が起きました。
両者が重なったまま集計すると、同じセッションが両方のグループで二重カウントされてしまいます。その結果、見かけ上のサンプルサイズが水増しされて信頼区間が実際より狭くなり、有意差が出やすくなる方向に壊れてしまいます。外見上は集計処理が正常終了してしまうため、気づくのが難しい不具合でした。 現在はCIの検査スクリプトに対象群と対照群のパス衝突を検知するバリデーションを追加して未然に防いでいます。
小規模アクセスにおける比率指標の限界
不具合を修正してデータを流し込み、検定を走らせたところで、統計のシビアな現実に直面しました。
このアクセス規模では、比率指標の変化がほぼ何も検出できないという事実です。
立ち上げ初期や小規模な個人開発サイト(週あたり数百セッション規模)では、標本サイズがどうしても限られます。 有意水準5%・検出力80%で統計的な差を検出するためにどれくらいの変化率が必要か、MDE(Minimum Detectable Effect:検出可能な最小効果量)を試算してみた結果がこちらです。
| 指標(実測ベース率) | 21日窓 | 42日窓 | 84日窓 |
|---|---|---|---|
engagement_rate (77.9%) | +24% | +17% | +11% |
event:scroll (49.6%) | +103% | +65% | +42% |
event:file_download (30.3%) | +133% | +82% | +53% |
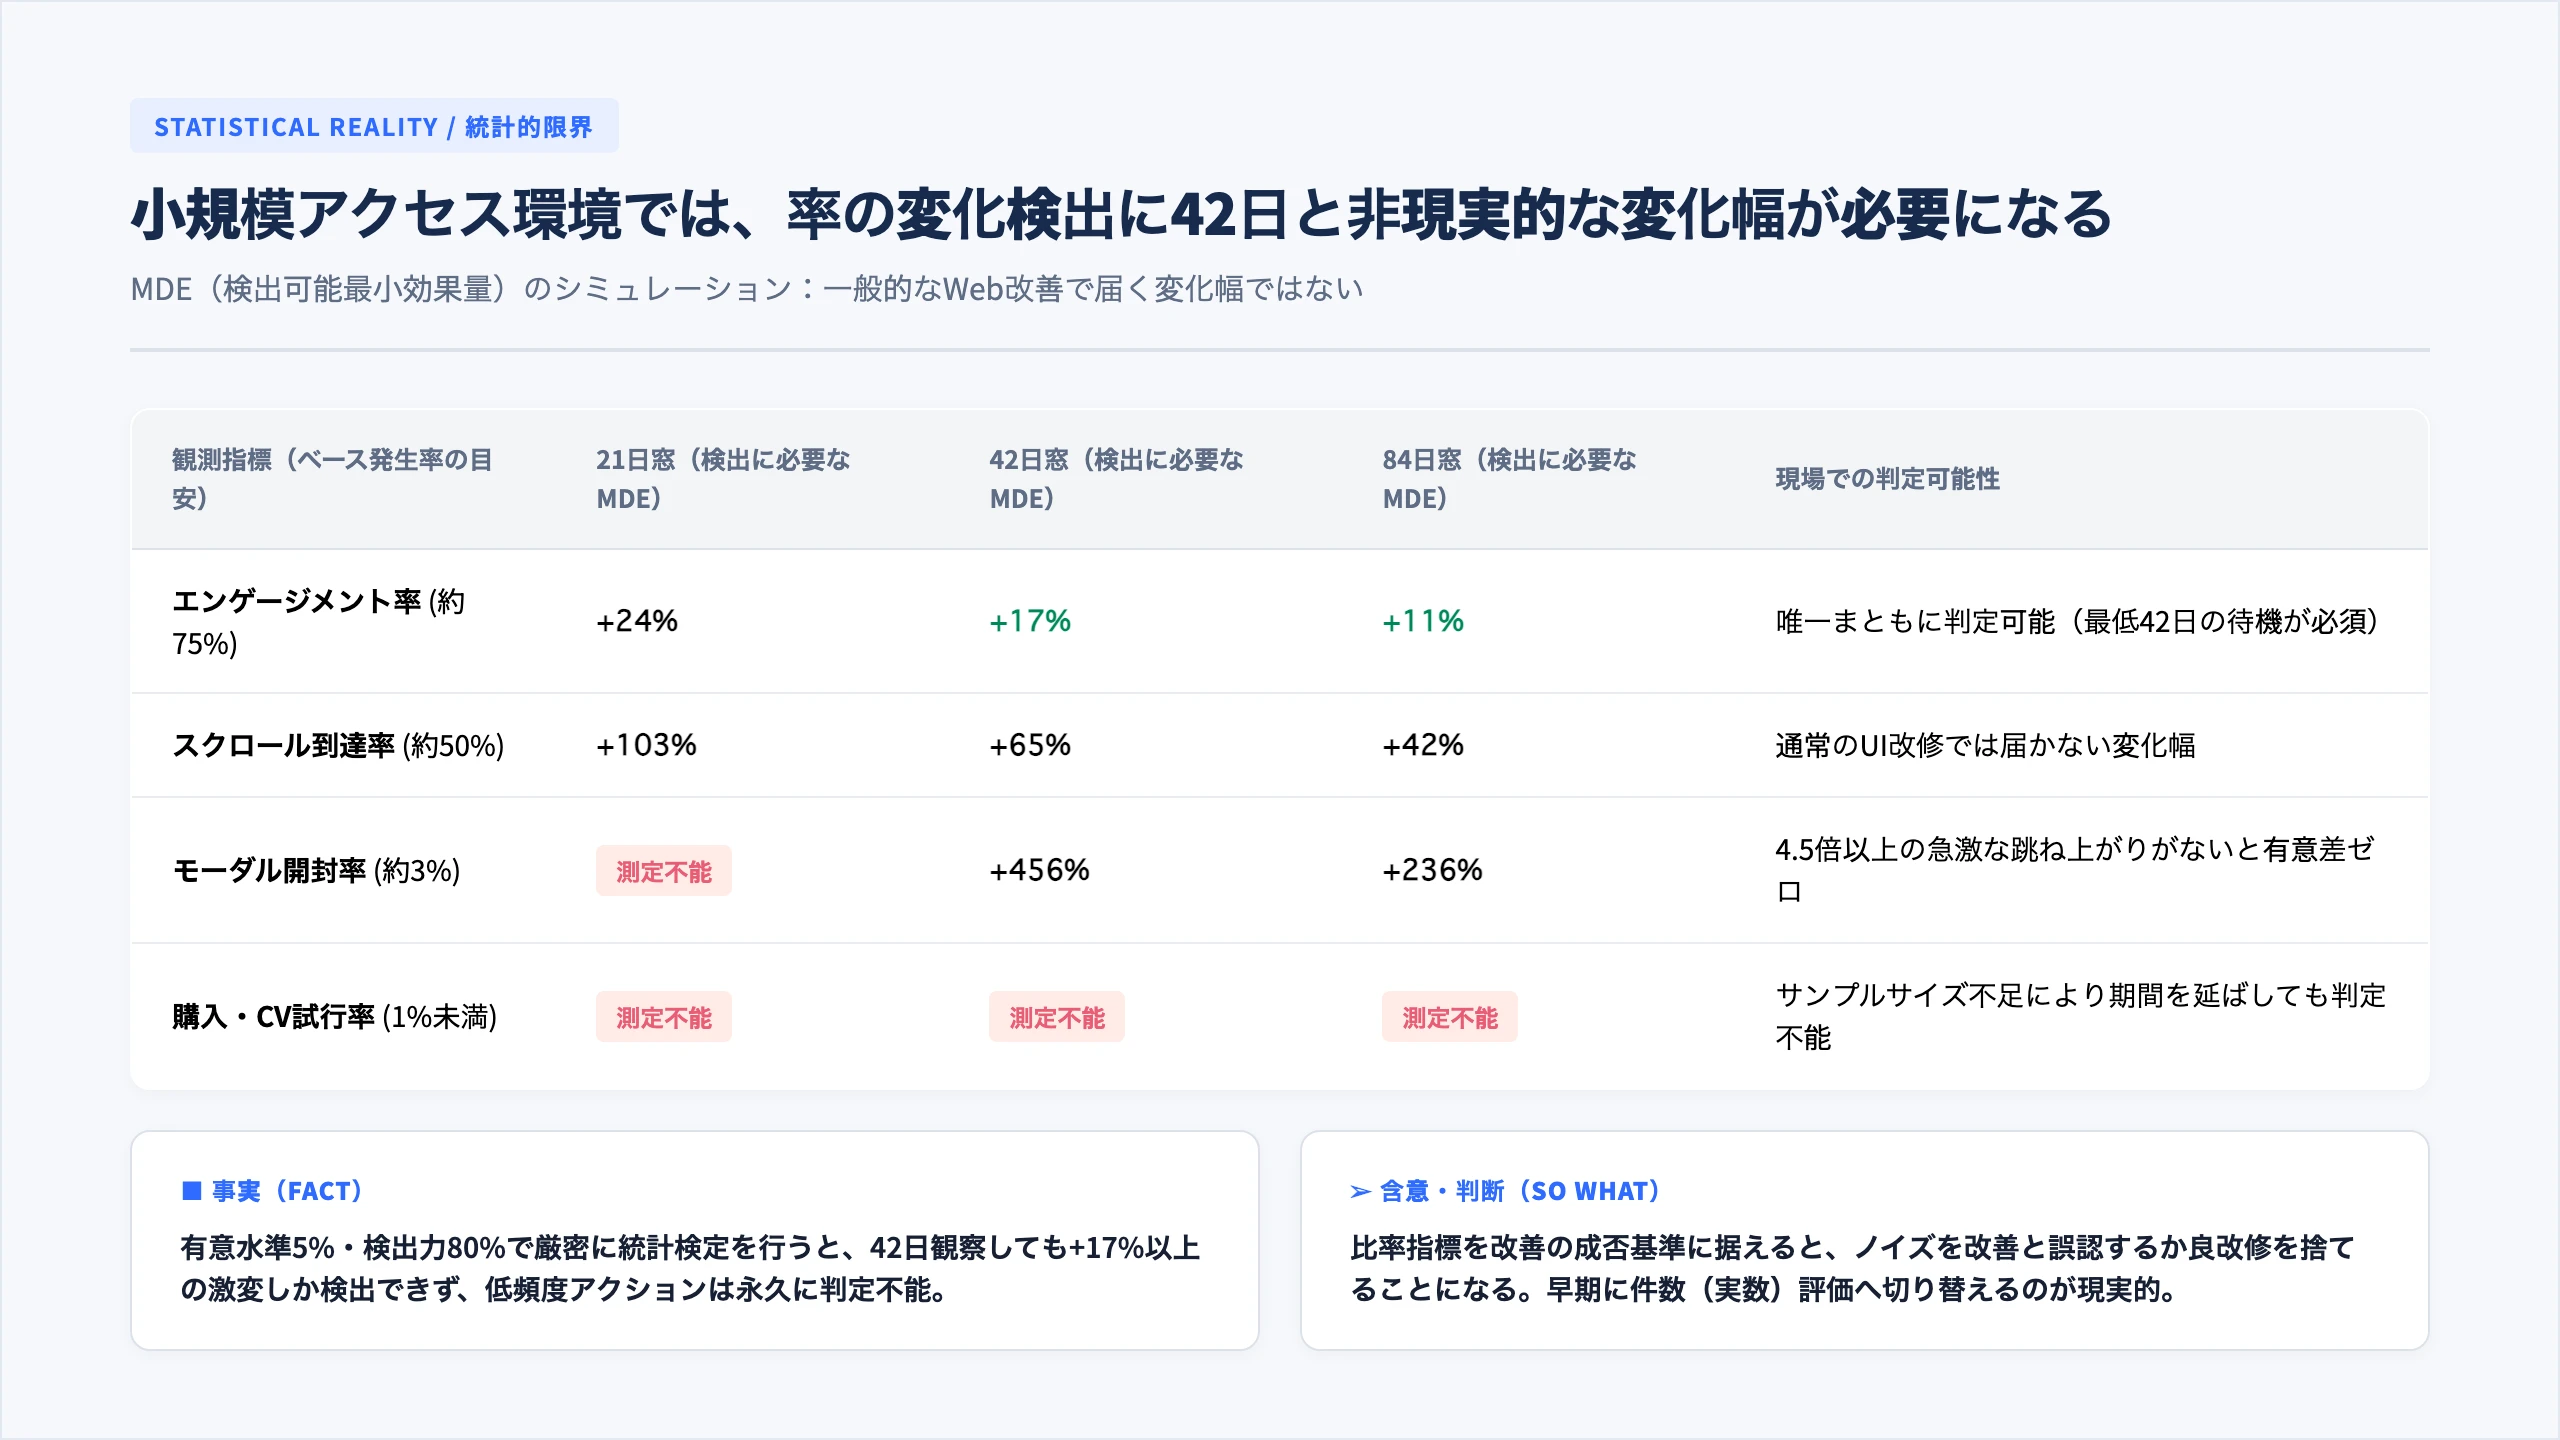
▲ 小規模アクセス環境におけるMDEの試算:一般的なUI改善で届く変化幅ではない
ボタンの色や文言を変えたくらいで、ダウンロード率が+82%も跳ね上がるわけがありません。 つまり、どれだけ綺麗にDiDを組んでも、小規模サイトでは判定不能が並ぶだけで何の意思決定にも使えなかったのです。
信頼区間の半幅をMDEと誤認していた計算ミス
MDEを算出する際、初期の計算ロジックにもミスがありました。 最初に作成したスクリプトでは21日窓の値が +16% と出ていたのですが、これは単に信頼区間の半幅(Margin of Error)をそのままMDEと呼んでしまっていた誤認でした。
真の効果量が信頼区間の半幅と同じだった場合、標本推定値は正規分布に従ってブレるため、半分の確率でそれを下回ってしまいます。つまり検出力は50%しかありません。 検出力80%(z_β ≈ 0.84)をきちんと確保するには、有意水準5%(z_α/2 ≈ 1.96)と足し合わせた 1.96 + 0.84 = 2.80 の係数が必要になります。正しく計算し直すと、+16% ではなく +24% が正しいMDEでした。
学び:合否は実数で即決し、率は安全装置へ格下げする
率の変化を追うのは早々に諦め、施策の合否(KGI)は必ず件数で定義するルールに変更しました。
kgi:
  name: 販売本数
  unit: 件/月      # 比率での指定はCIエラーで弾く
  baseline: 0
  target: 3
率は42日待っても判定不能になりがちですが、件数なら数えるだけです。今月3件売れたかどうか。これなら統計検定など不要で、誰が見ても一瞬で白黒がつきます。
苦労して構築したDiDは、改善判定ではなく重大な不具合による数値の暴落を監視する安全装置(ガードレール)として位置づけ直しました。サイトが壊れたときは数値が急落するため、微細な有意差を見る必要がなく、しっかり機能してくれます。
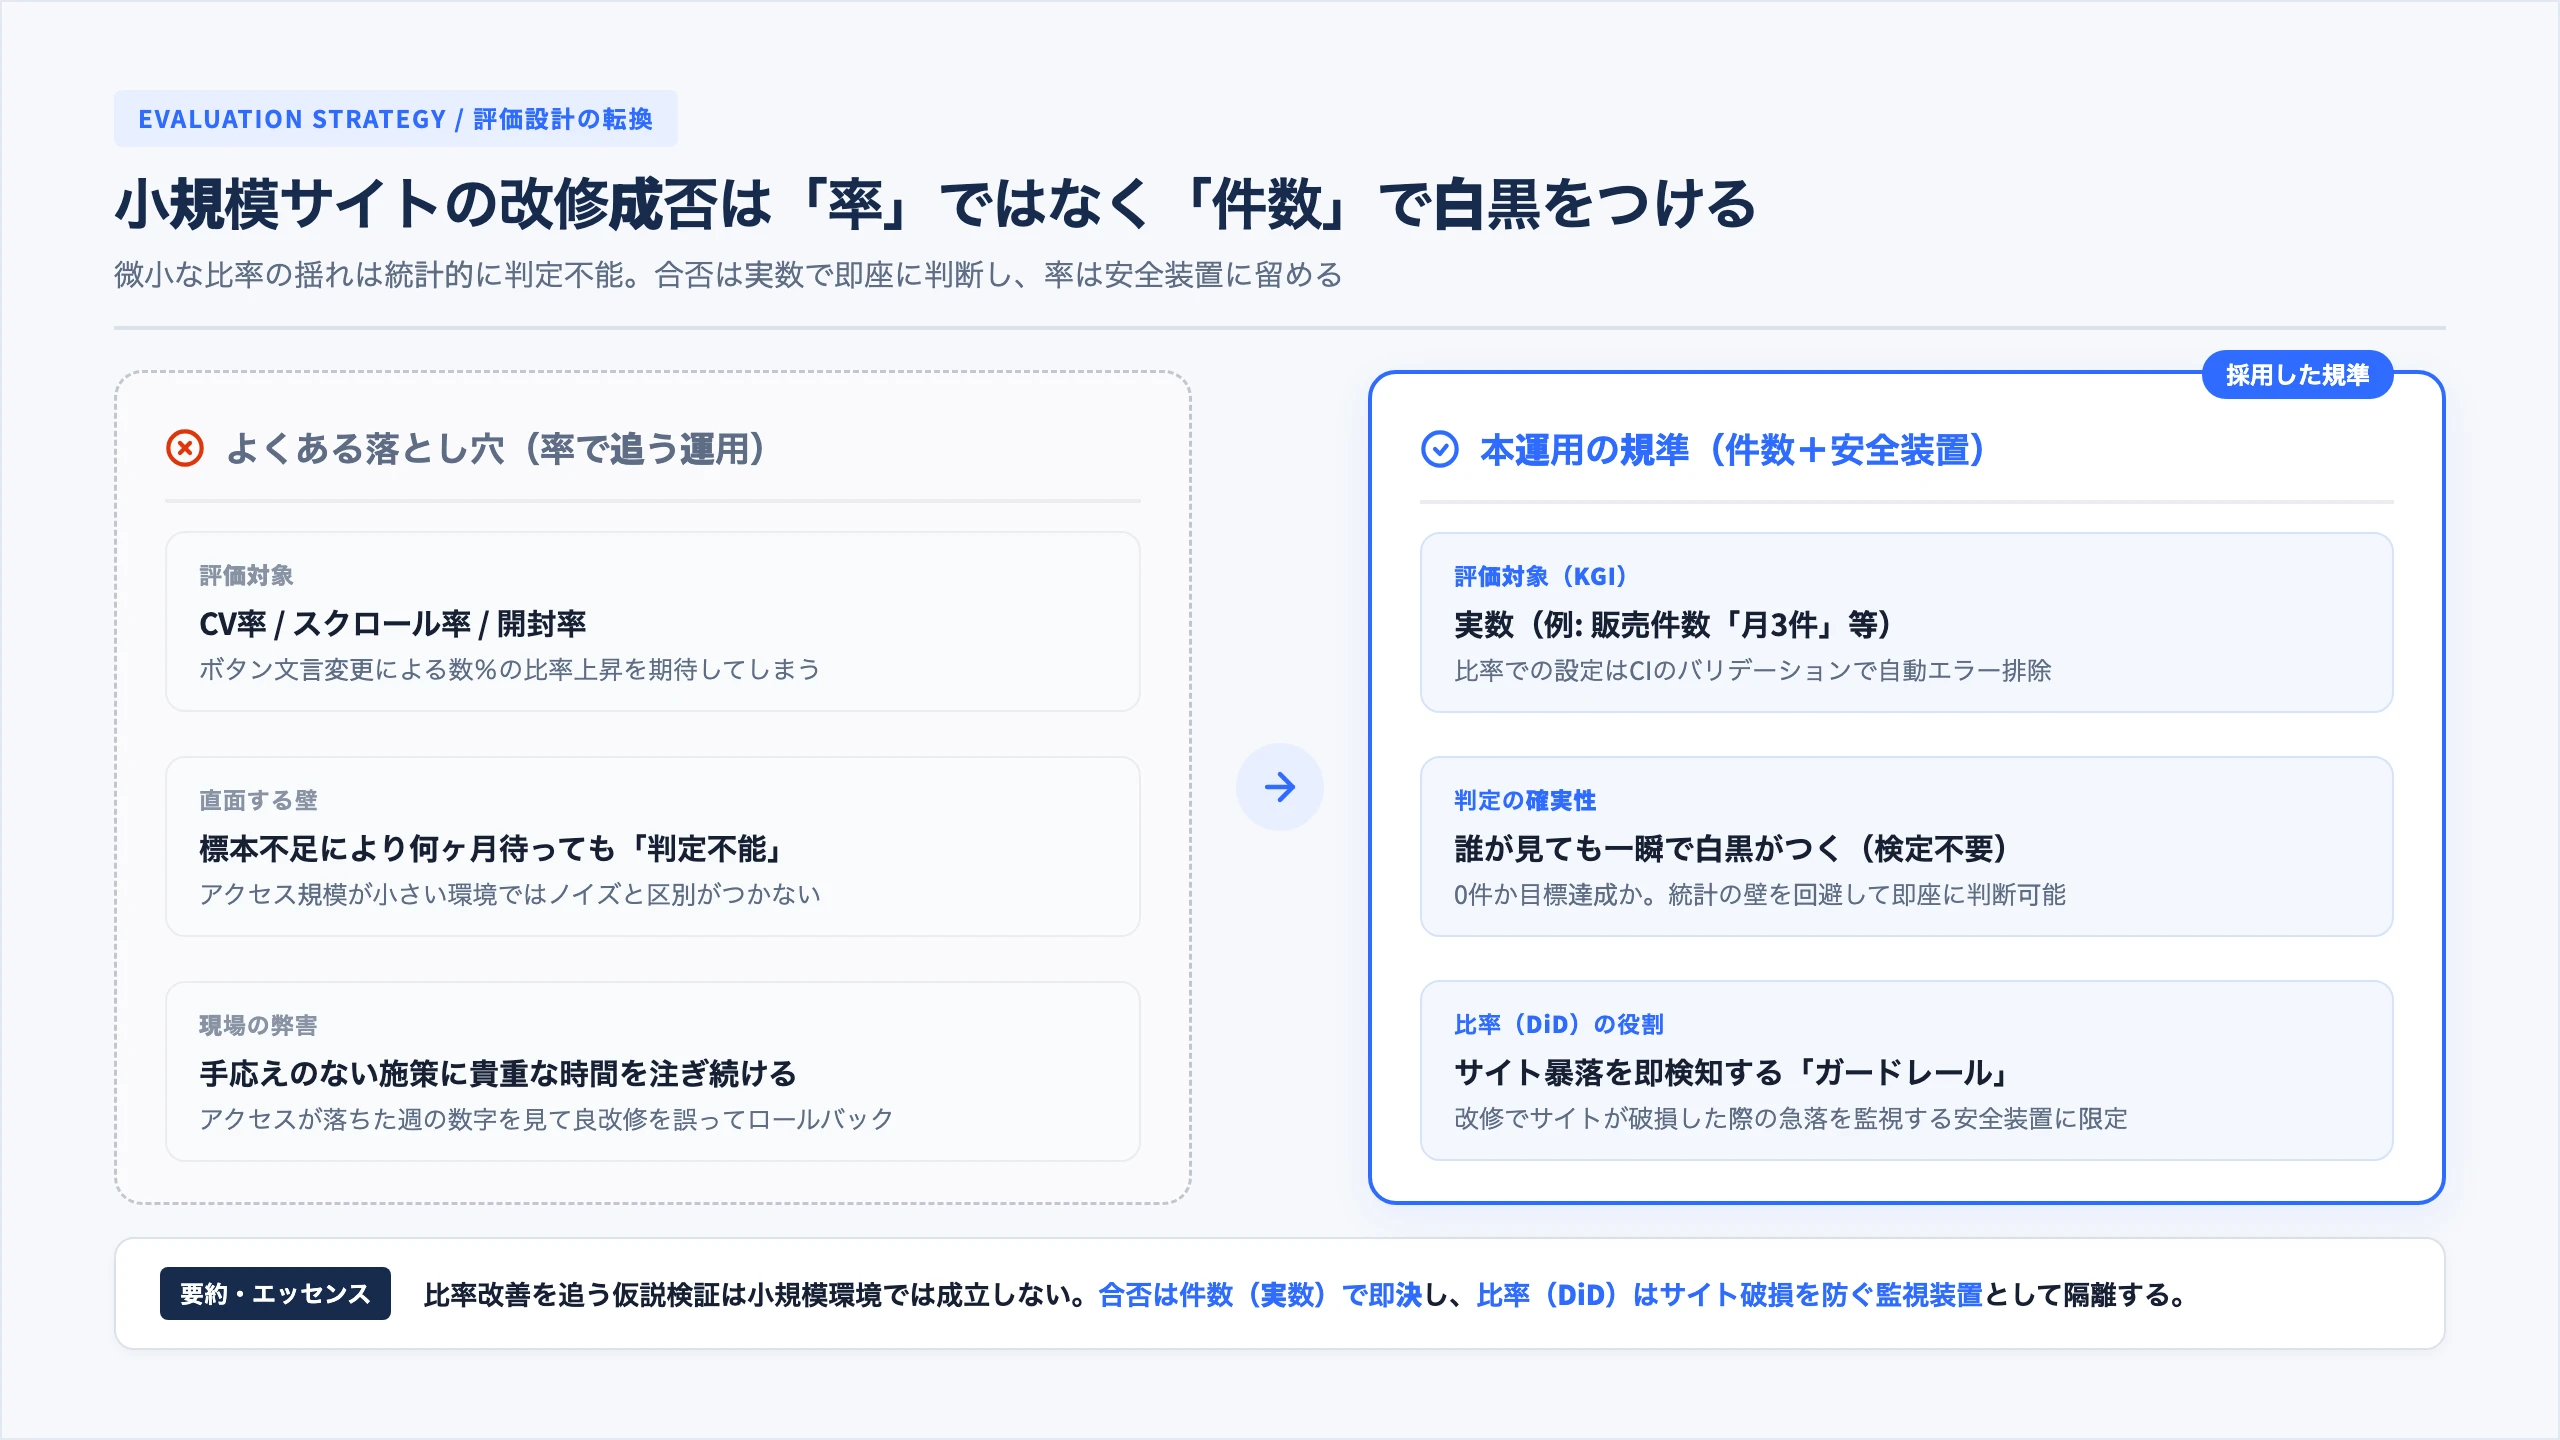
▲ 評価設計の転換:合否は件数で即決し、比率はサイト破損の安全装置に限定
2. 後出しルールと自分への甘さ
測る仕組みができたあと、次に取り組んだのは、測定結果を受けて次にどう動くかの自動化でした。
週次でレポートを自動生成する仕組みを作ったのですが、通知が届くだけだと結局スルーして見なくなってしまいます。 また、このアクセス規模だと生レポートをそのままLLMに渡して施策を考えさせても、毎週もっともらしいけれど中身のない提案が並ぶだけでした。
そこで、施策台帳(initiatives.yml)にあらかじめ条件に応じたバックログの採択ルールをコードとして書いておく構成にしました。
decide:
  review_at: 2026-10-04
  rules:
    - when:
        - {kpi: モーダル開封数, op: ">=", value: 30}
        - {kpi: 開封クリック率, op: "==", value: 0}
      then: modal-content
      note: 入口は足りている。ボトルネックは中身にある
機械は事前に書かれたルールを照合するだけ。人間の思考をあらかじめコード化しておくアプローチです。
結果を見てから条件を書き足していた問題
ところが運用を始めて数日後、Gitのコミットログを見返していて深刻なルール違反に気づきました。
2026-08-30 12:46  baseline を実測して台帳に書いた
2026-08-30 22:54  同じファイルに分岐ルールを足した
追加された分岐条件の1つは、開封クリック率 == 0 でした。
クリックが0件だったという集計結果を確認してから、その条件を後出しで書き足していたのです。
これは仮説検証でもなんでもありません。単なるカンニングであり、観測結果の後付けの書き写しです。 書いた瞬間に成立することが確定している分岐は、判断を先送りしただけで何の検証にもなりません。
結果を見てから後出しで条件を追加してはならない原則は、仕組みを作った自分自身が一番よく分かっていたはずでした。それなのに、無意識に破ってしまっていたのです。 原因は明白で、ファイルを開いたときにそのルールがいつ記述されたものなのか判別できなかったからでした。
記述日の必須化と機械による検知
すべての分岐ルールに記述日(written_at)の入力を必須フィールドとして強制しました。
rules:
  - written_at: 2026-08-30      # 欠落しているとCIでエラー
    when: [...]
そして観測開始日と比較し、後から追加されたルールには、レポート上で明確に警告を出すようにしました。
⚠ この分岐は 2026-08-30 に追記(観測開始 2026-08-29 より後)。
  数字を見てから書かれた可能性があるので、事前に立てた仮説としては読まないこと
遵守状況を機械的に検証できないルールは、作った本人ですら破ってしまいます。 ルールを設けるなら、違反が機械的に検知される仕組みもセットでコードにしておかなければ形骸化することを学びました。
3. 借り物のフレームワーク
この改善サイクルを回し始めた当初、自分はこの仕組みをOODAループ(Observe ➔ Orient ➔ Decide ➔ Act)と呼んでいました。 プロダクト開発でよく使われる、変化に素早く適応するためのフレームワークです。
しかし運用を続けるうちに、大きな違和感が生じました。
探索と検証の混同
一般的なOODAにおけるObserve(観察)は、市場や競合、ユーザーの予期せぬ変化にアンテナを広げる探索的な行為です。 一方、自分が組んだパイプラインがやっていたのは、あらかじめ定めたKPIが閾値を超えたかどうかを機械的に確かめるだけの作業でした。
探索(新たな発見を拾うこと)と、検証(決めた数値を測ること)は全く逆の性質を持ちます。検証パイプラインしか作っていないのに、探索の看板を掲げていた状態でした。
OODAと事前登録のベクトルの違い
OODAの本質は、観察から判断までの速度にあります。 対して、自分が構築した仕組みの本質は、9割が事前登録(Pre-registration)の思想そのものでした。
事前登録とは、臨床試験や心理学の世界で結果を見てから都合よく仮説を後付けするミスを防ぐための手法です。こちらの本質は、結果を見る前に定めた手順を崩さない厳密さにあります。 両者の思想は、向いている方向が正反対でした。
小規模サイトにおける観察コストの逆転
OODAの前提:  観察は一瞬(安価)、判断が遅い   ➔ 判断速度を極限まで上げれば勝てる
小規模の現実: 観察に42日かかる(極めて高価)、判断は15分 ➔ 高価な観察を事前に配給するしかない
アクセスの少ないサイトにおいて、施策の影響を確認するには最低でも42日かかります。観察リソースが極端に高価なのです。 小規模サイトにおいて一番のリスクは、市場の変化を見落とすことではなく、変化の出ていない改修を成功だと思い込み、貴重な時間を使い続けてしまうことです。
42日間の待機を前提とした再設計
OODAという看板を外し、実際の作業ステップを整理したところ、5つの段階に集約されました。
- ① 決める: 数字を見る前に、狙いと分岐条件をコードに書く(人間)
- ② 打つ: 改修コードを書き、ログを同一コミットに入れる(人間 + AI)
- ③ 待つ: 42日間、じっと待つ(縮められない)
- ④ 測る: 週次バッチで改善・悪化・判定不能を自動算出する(機械)
- ⑤ 読む: 隔週で人間が判断し、次の1手を決める(人間)
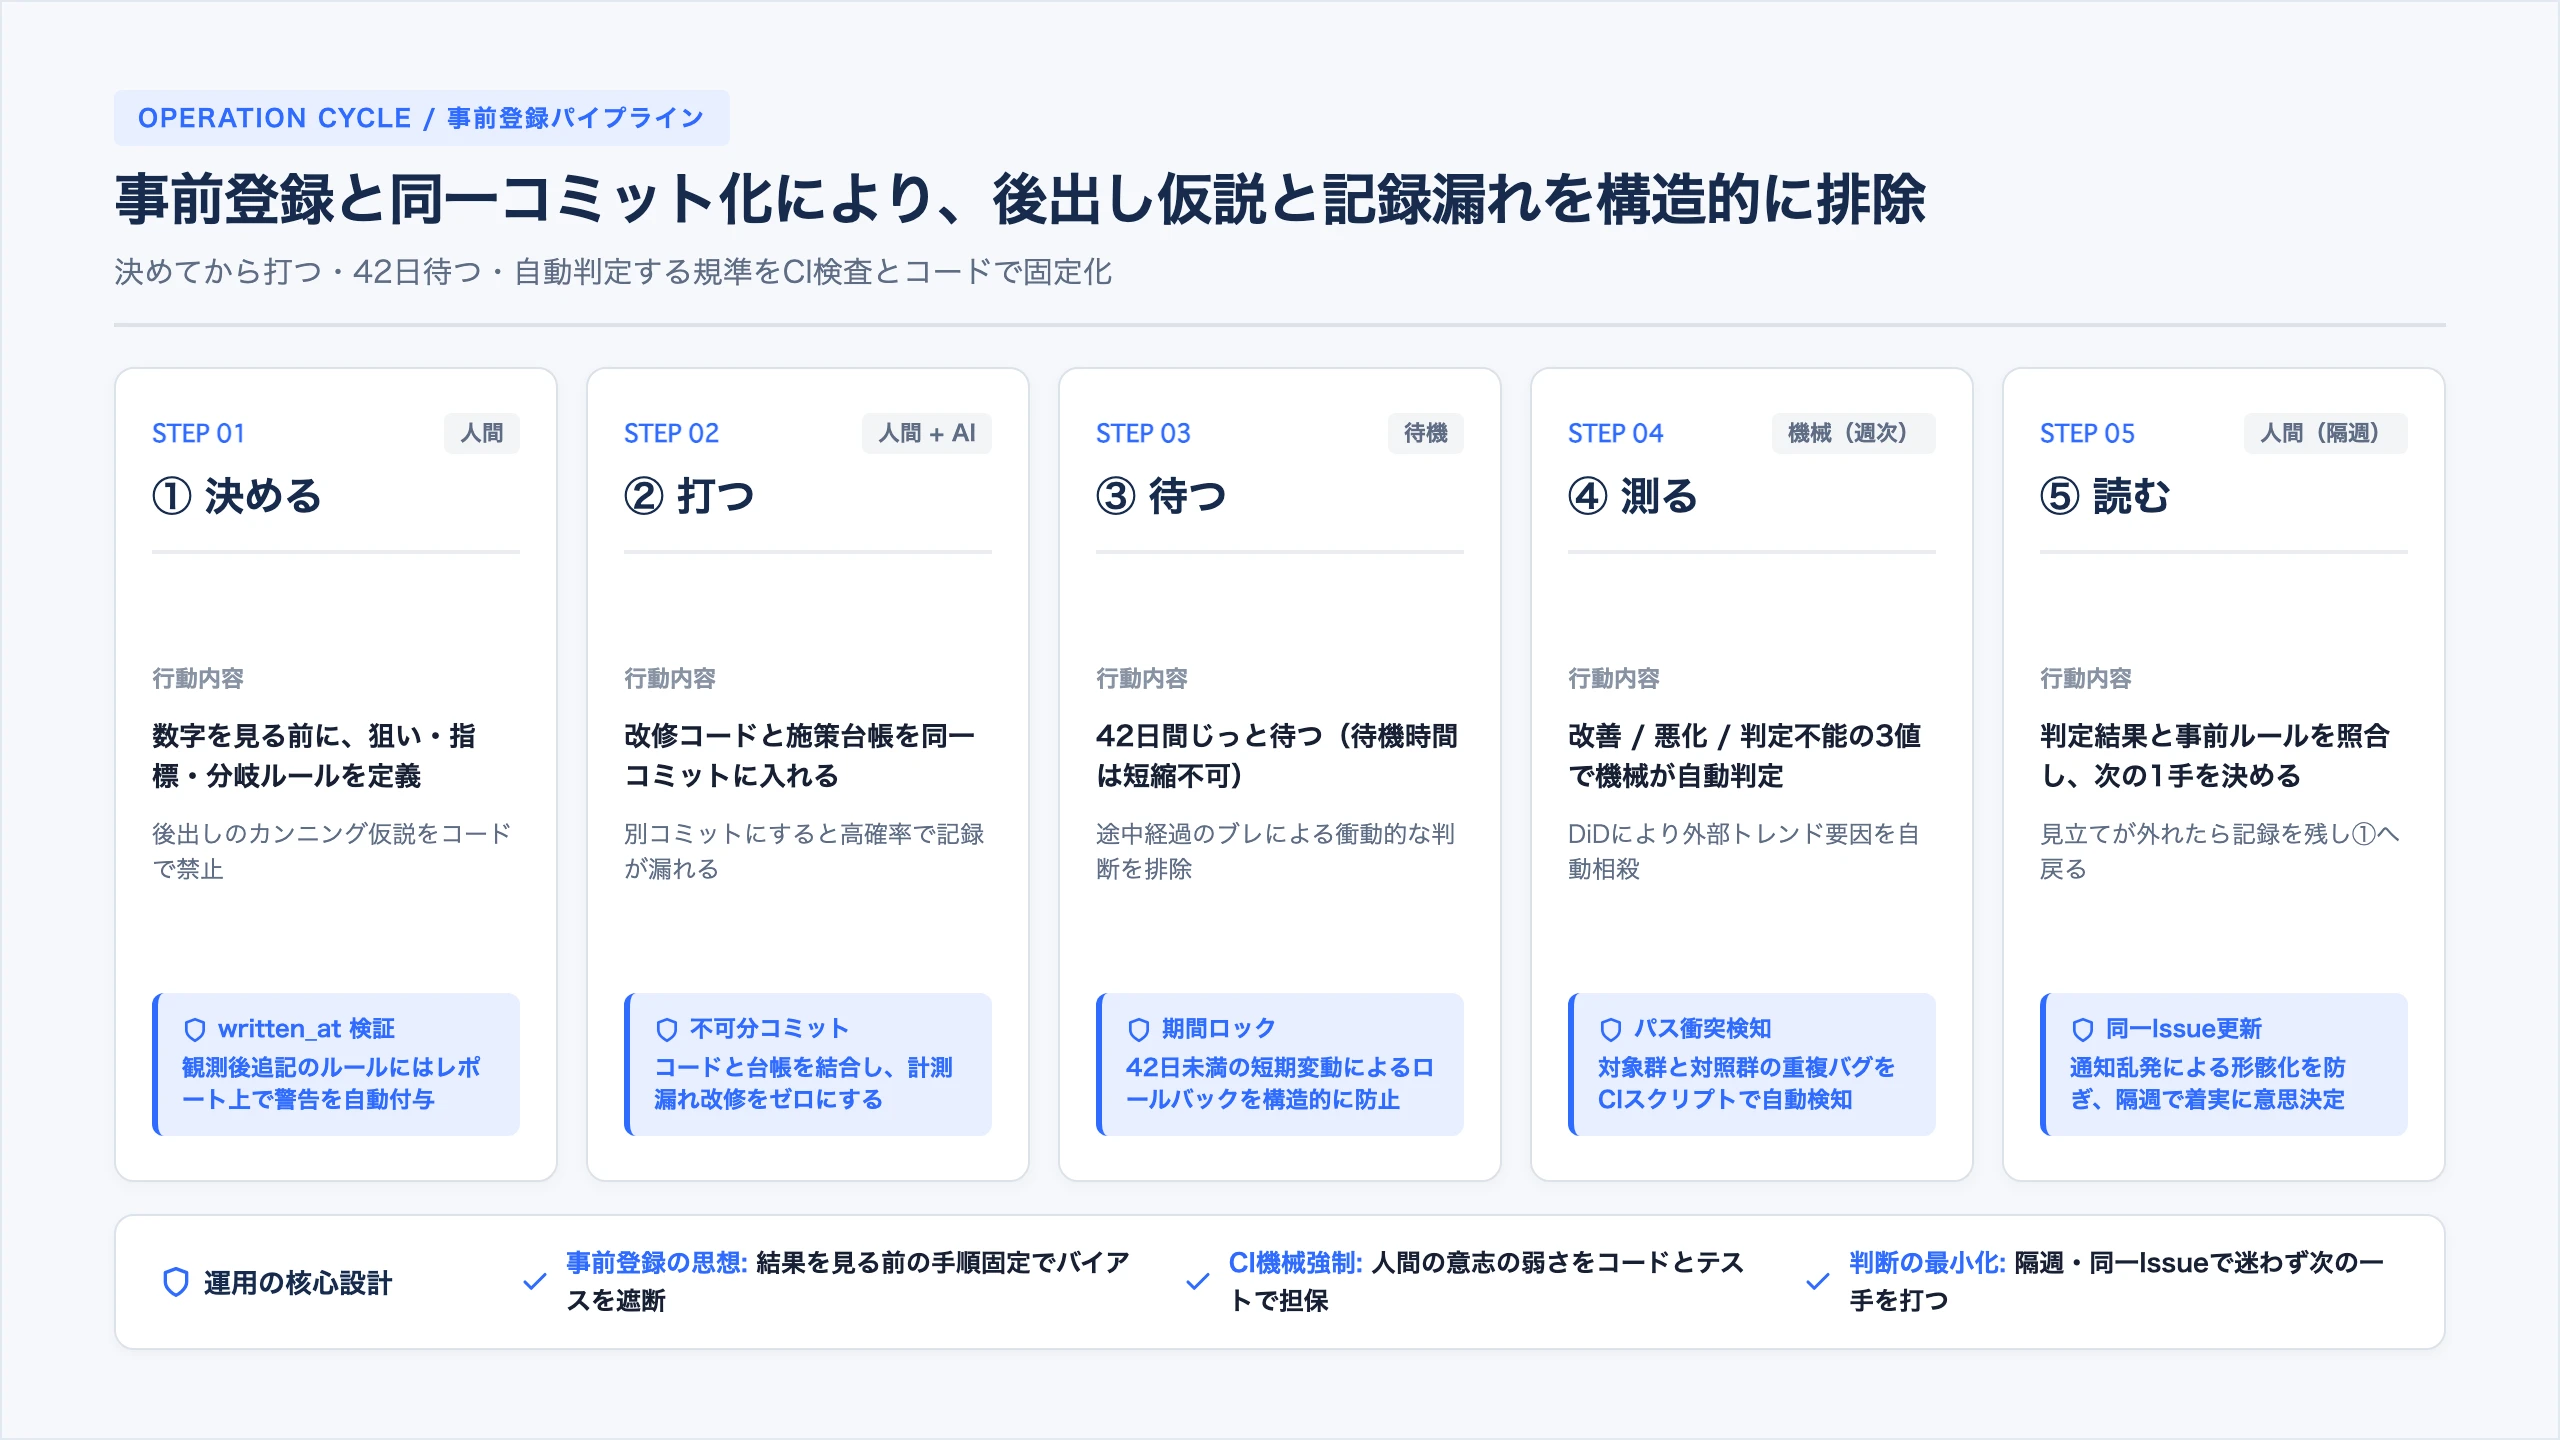
▲ 事前登録ルールと不可分コミットによる5ステップ運用サイクル
OODAのフレームワークに待機というフェーズは存在しません。素早い意思決定の遅延を想定していないためです。 しかし、小規模なWebの効果測定において、42日間じっと待つことは避けて通れない一番長い待ち時間であり、完全に正常な運用です。
この待ち時間を無視した設計図を見ていると、早く回そうと焦って無駄な改修を重ねてしまいます。 42日の待機を前提としたサイクルへ再設計したことで、不要な焦りや無理な改修を避けられるようになりました。
4. 実装時の技術トラブル
パイプラインを構築・運用する過程で、予期せず時間を要したトラブルもいくつかありました。
YAMLのインラインコメントで文字列が消える
next: 導入ガイドのサンプル画像を置く(issue #10)
YAMLの仕様上、クォートで囲まれていない文字列の中に 半角スペース + # があると、それ以降がコメントとして扱われて静かに切り捨てられてしまいます。
上記の場合、導入ガイドのサンプル画像を置く(issue という中途半端な文字列としてパースされてしまいます。構文エラーにはならず正常終了するため、発見が遅れやすい落とし穴でした。
現在はCIの静的解析で正規表現チェックを入れ、インラインコメントが含まれていたら弾くようにしています。
演算子の定義が二重化して片方だけ壊れる
分岐ルールの比較演算子(>=, ==, < など)を処理するロジックが、評価スクリプトとCI検査スクリプトの2箇所に別々に書かれていました。
検査側に新しい演算子を追加した際、評価エンジン側の辞書に追加し忘れたことで、CIは通るのに実行時に未対応の演算子として毎回不成立になり、分岐が無言で無視される障害が発生しました。現在は共通モジュールに演算子処理を集約し、単体テストで一致を保証しています。
launchdによるローカル定期実行の限界
当初、週次集計ジョブは手元のMacの launchd で動かしていました。
しかし、Macがスリープ状態だとジョブがスキップされたり、失敗の検知が遅れたりと課題が多くありました。最終的にはすべてGitHub Actionsへ移行し、失敗時は即座にワークフローを落としてIssueを作成する構成に改めています。
GA4と Search Consoleの母集団の不一致
GA4のAPIを叩く際、ローカル開発環境のアクセスを除外するために hostName の完全一致フィルタをかけたところ、www 付きのアクセスが静かに除外される事故が起きました。
また、Search Console APIはプロパティ設定によってサブドメインを含む全URLを合算して返してきます。実測したところ、検索表示回数の80%以上が別用途のサブドメイン側に偏っていました。
GA4とSearch Consoleの数値を単純に足し合わせたり、比率の分母分子にしてはいけません。ホストの境界線は必ず揃える必要があります。
まとめ
設計を3度作り直して得られた一番の学びは、自分の甘えを疑う仕掛けをコードに落とし込むことでした。
- 前後比較の直感を疑う ➔ 対照群(DiD)を置いて外部要因を相殺する
- 改善したという思い込みを疑う ➔ MDEを計算し、検出力不足の指標は判定から外す
- 自分がルールを守るという善意を疑う ➔ 記述日(
written_at)を必須にして後出しルールを警告する - 借り物のフレームワークを疑う ➔ 42日の待機を前提としたサイクルへ再設計する
アクセスの少ないサイトほど、数字はどのようにでも都合よく解釈できてしまいます。 20個の指標を適当に眺めていれば、偶然の偏りでどれか1つの指標は見かけ上の有意差が出てしまうものです。 だからこそ、指標と分岐ルールは改修コードの前にコミットしておかなければなりません。
判定不能を、都合よく改善傾向と言い換えない。 サンプルサイズの不足を、成果と勘違いしない。
この一線を崩してしまうと、どれほど自動化パイプラインを作り込んでも、客観的な検証ツールとしては機能しなくなってしまいます。
こうして数々の失敗を経て完成した、現在の自走アーキテクチャの具体的な設計とコード運用については、ぜひ【実践・システム設計編】をご覧ください。
泥臭い失敗談に最後まで付き合ってくれてありがとう!
自分の意志の弱さを疑って仕組みとコードで縛るアプローチって、ちょっと悔しいけれど一番確実だったりするんだよね。
現在実際に動いている仕組みは【実践・システム設計編】で詳しく解説しているから、ぜひそっちも読んでみてね!またねー!